

Panne Microsoft 365, Outlook, Teams : ce qui s’est passé
En bref. Depuis le jeudi 12 novembre 2026 (début d’impact à 16 h 17 UTC), une panne mondiale perturbe Microsoft 365 : Outlook et Exchange Online en premier, mais aussi le calendrier Teams, SharePoint, OneDrive et Copilot, dans au moins 74 pays et territoires selon Downdetector. Microsoft indique n’avoir aucune indication d’activité malveillante. La cause racine n’est pas confirmée : des serveurs sont tombés, la charge s’est reportée sur les autres, et les serveurs remis en service retombent dès qu’ils reçoivent du trafic. À ce stade, vos e-mails sont retardés, pas perdus. Voici la chronologie, ce qui est confirmé (et ce qui ne l’est pas), une lecture technique de l’incident et quoi faire dès maintenant.
Article mis à jour le 13 novembre 2026. Au dernier point que nous avons pu vérifier (vers 12 h, heure de Paris), Microsoft n’avait pas déclaré l’incident résolu et aucun post-incident report n’était publié. Nous mettrons cette page à jour. Les heures sont en UTC : ajoutez 1 h pour Paris et Casablanca.
Panne Microsoft 365 aujourd’hui : ce qui est touché
Si Outlook n’envoie plus, ne reçoit plus ou affiche des messages avec des heures de retard, vous n’êtes pas seul : c’est une panne côté Microsoft, pas un problème de votre poste ni de votre connexion.
Services signalés comme perturbés (selon Euronews, UC Today, Presse-citron, ITdaily et NBC News) :
- Outlook (web, application de bureau, ActiveSync, API) et Exchange Online, le plus touché ;
- Teams : le chat et les réunions fonctionnent en grande partie, mais le calendrier et la création d’événements Teams échouent ;
- SharePoint Online, OneDrive, OneNote, Planner, To Do ;
- Copilot ;
- côté administration : Defender, Intune, Purview ;
- les liens réécrits par Safe Links (Defender for Office 365) ne s’ouvrent plus depuis Outlook ou Teams (ITdaily).
Certaines sources divergent sur Teams et SharePoint : l’un d’eux est parfois cité comme « touché », parfois comme « en grande partie fonctionnel ». C’est cohérent avec une panne partielle et intermittente, qui varie selon la région et le locataire.
Ampleur. Downdetector a enregistré des signalements dans 74 pays et territoires. Au pic, le nombre de signalements pour Outlook va d’un peu plus de 120 000 à près de 140 000 selon les sources. Radio-Canada fait état de plus de 20 000 incidents au seul Canada.
Effets en cascade sur d’autres outils. Des services tiers qui dépendent de la messagerie ou du calendrier Microsoft ont aussi eu des problèmes (Zoom, Webex, HubSpot, Calendly, Notion, Jira, selon ITdaily). Les connecteurs Microsoft 365 des assistants IA (Claude, ChatGPT) étaient également en échec : OpenAI et Anthropic ont signalé des difficultés avec leurs connecteurs Microsoft (NBC News).
Organisations touchées (d’après CNBC, NBC News et Radio-Canada) : des cabinets médicaux et des services de santé au Royaume-Uni (le NHS précise que les patients doivent se présenter normalement), la police du West Yorkshire, des communications inter-ministérielles au Japon, le gouvernement de Singapour, des ministères fédéraux et le réseau hospitalier Unity Health à Toronto (soins non affectés). Côté entreprises : Euronext, Aviva, Maersk et plusieurs compagnies aériennes indiennes ont signalé des perturbations de messagerie, tandis que Richemont et Workhorse ont décalé des publications de résultats. Dans plusieurs villes américaines (Baltimore County, Jacksonville, Austin, New York), les e-mails municipaux ont été touchés, mais le 911 est resté opérationnel.
Et le Maroc ? Nous n’avons trouvé aucune source chiffrée spécifique au Maroc. La panne étant mondiale, les entreprises marocaines qui reposent sur Microsoft 365 y sont exposées de la même manière.
Chronologie de la panne (12–13 novembre 2026)
| Heure (UTC) | Événement | Source |
|---|---|---|
| Jeu. 12 nov., 16:17 | Ouverture de l’incident EX1550543 (Exchange Online). Microsoft place le début d’impact à 11 h 17, heure de New York. | UC Today, LazyAdmin, NBC News, ITdaily |
| ≈ 17:54 à 18:07 | Impact signalé aux Amériques, puis dans toutes les régions | UC Today |
| 18:26 | Ouverture de l’incident MO1550821 (impact Microsoft 365 plus large) | UC Today, KBY Technologies |
| ≈ 19:06 | Microsoft suspend les déploiements et les changements de configuration | UC Today, LazyAdmin, ABC News |
| ≈ 21:00 | Une autre méthode de contrôle de santé des serveurs est validée ; des serveurs reviennent en service | CNBC, LazyAdmin |
| Dans la nuit | Des serveurs rétablis redeviennent non réactifs dès qu’ils reçoivent du trafic | @MSFT365Status (via Cybersecuritynews), UC Today |
| Ven. 13 nov., ≈ 04:10 à 04:22 | Premiers signes de récupération partielle | UC Today (04:10), LazyAdmin (04:22) |
| ≈ 05:00 | Capacité augmentée avec des machines virtuelles supplémentaires ; des machines restent « bloquées dans un mauvais état » | LazyAdmin, UC Today |
| 06:56 | « Succès marginal » | UC Today, Euronews |
| 07:25 | « Résultats positifs sur la stabilité des serveurs » ; prochaine mise à jour à 08:30 ; aucun délai de rétablissement | UC Today |
| ≈ 11:07 | La capacité n’est « pas encore revenue à son niveau de base » | Presse-citron (12 h 07, Paris), citant @MSFT365Status |
Les sources se contredisent sur quelques horaires (par exemple 04:10 contre 04:22 pour la reprise partielle) : nous indiquons les deux. La page de statut officielle fait foi.
Cause de la panne : ce que Microsoft a dit (et ce qui reste à confirmer)
Confirmé
- Pas de cyberattaque identifiée. Charles Lamanna, vice-président exécutif de Microsoft, déclare qu’il n’y a aucune indication d’activité malveillante.
- Des serveurs indisponibles de façon inattendue, ce qui met sous pression le reste de l’infrastructure (Microsoft, cité par CNBC). Certains serveurs ont échoué aux contrôles de santé automatiques et sont sortis du service.
- Les serveurs restaurés peuvent retomber dès qu’ils reçoivent du trafic (compte @MSFT365Status).
- Microsoft a suspendu tous les déploiements, déplacé du trafic hors de l’infrastructure touchée et redémarré des serveurs (ABC News).
- La fenêtre de nouvelle tentative des e-mails a été étendue à 48 heures (CNBC, NBC News).
- Un Post-Incident Report est promis une fois le problème atténué.
Pas encore confirmé
- Un changement de configuration réseau récent. Microsoft a annulé un changement dont le timing correspond au début de l’incident. Mais corrélation ne veut pas dire causalité : vers 19:57, Microsoft aurait même indiqué n’avoir trouvé aucun changement correspondant (KBY Technologies, LazyAdmin).
- Un processus de connexions sécurisées saturé : des serveurs cessent de traiter les requêtes quand il est submergé (UC Today).
- Un correctif sur un composant d’authentification ou de routage en amont : cité dans une mise à jour rapportée par NBC News, sans autre confirmation.
- Une mise à jour défaillante : c’est la lecture du ministre australien de l’Intérieur, Tony Burke, qui compare l’épisode à CrowdStrike (CNBC, NBC News). Ce n’est pas une déclaration technique de Microsoft.
- La cause racine : elle apparaît comme « N/A » dans le centre d’administration (UC Today).
À noter : Microsoft a d’abord évoqué une « charge élevée », puis précisé que l’incident n’était pas lié à une hausse du trafic. Le récit a évolué en cours de route, ce qui est normal pendant un incident, mais il faudra attendre le rapport final.
Pourquoi une panne comme celle-ci s’amplifie : lecture technique
Microsoft n’a pas publié son diagnostic. Ce qui suit est notre analyse à partir des éléments publics, pas une explication officielle. Elle s’appuie sur des mécanismes bien connus des ingénieurs d’infrastructure.
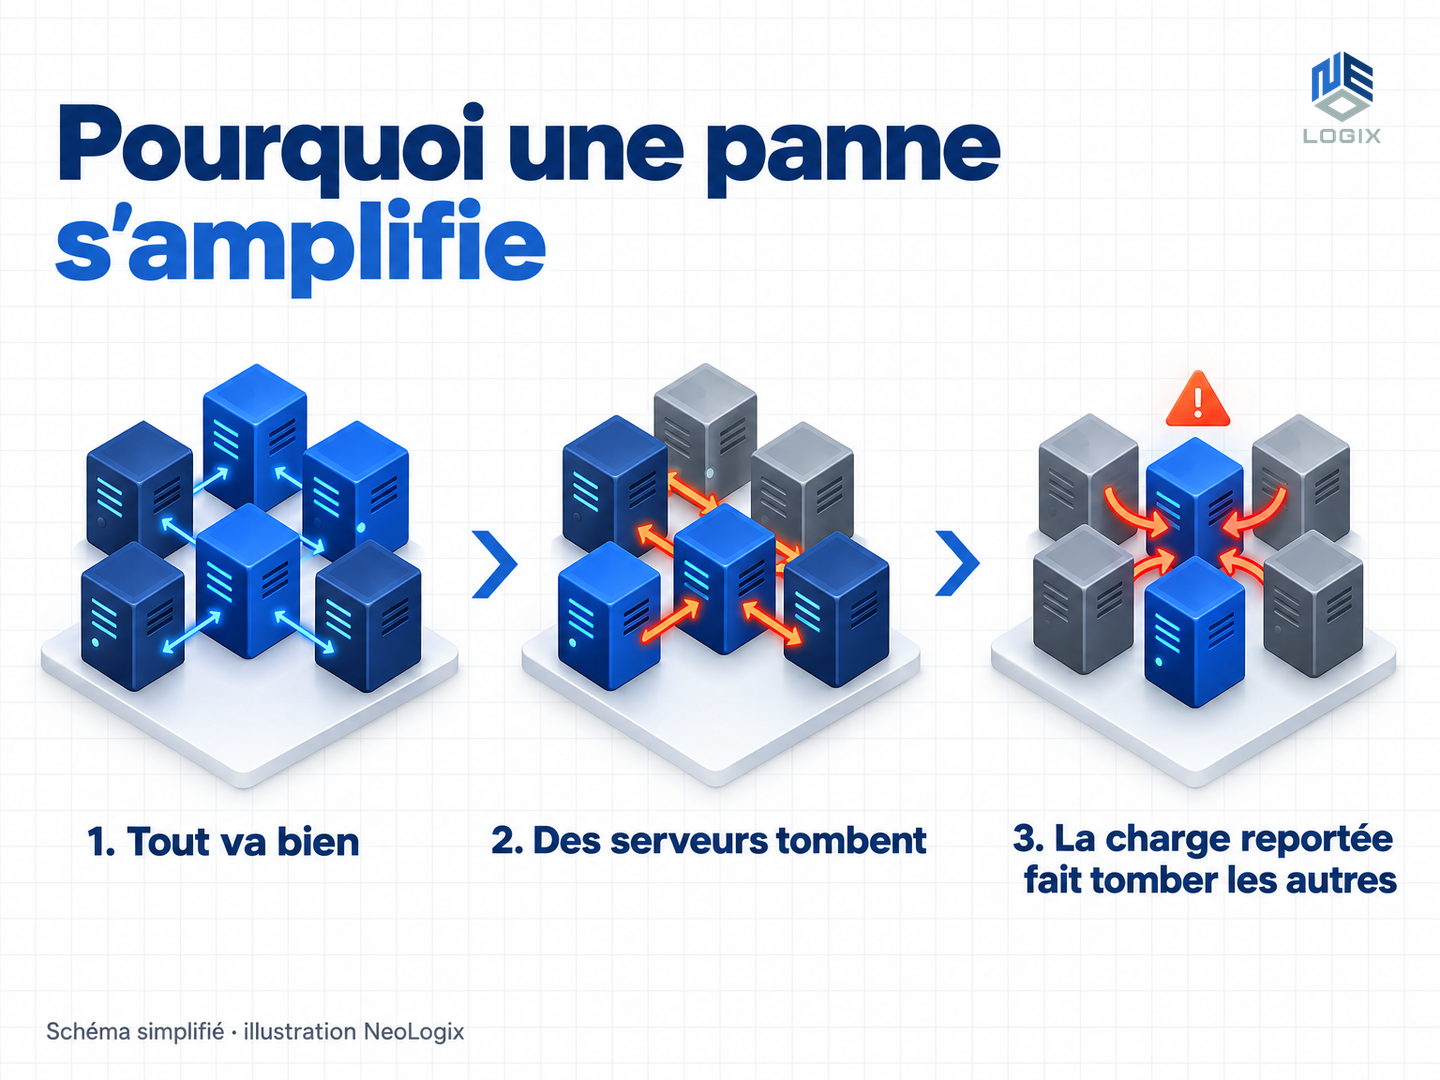
1. Les contrôles de santé : un garde-fou qui peut se retourner contre vous. Un répartiteur de charge retire automatiquement du service les serveurs qui échouent à leurs health checks. Quand quelques serveurs tombent, les autres reprennent leur trafic. Si ce surcroît les fait à leur tour échouer aux contrôles, ils sont retirés eux aussi : la capacité diminue précisément quand la charge augmente. C’est une panne en cascade.
2. Le problème des serveurs qui « retombent » au retour du trafic. Microsoft a indiqué que des serveurs rétablis redevenaient non réactifs dès qu’ils recevaient du trafic. Ce comportement est typique d’un redémarrage à froid sous charge : caches vides, connexions à rétablir, et surtout une file de clients qui se reconnectent tous en même temps. Dans les systèmes de messagerie, chaque client Outlook, chaque appareil mobile et chaque application connectée retente sa connexion. C’est l’effet de troupeau (thundering herd) : le retour du trafic recrée la surcharge qui avait fait tomber les serveurs.
3. L’effet des connexions sécurisées. Une source décrit un processus de connexions sécurisées saturé. Établir une session sécurisée (négociation TLS, authentification) coûte nettement plus cher en calcul que de servir une requête déjà établie. Quand des milliers de clients tentent de se reconnecter simultanément, ce coût se concentre au pire moment. Il s’agit là d’une explication plausible, pas d’un fait confirmé.
4. Pourquoi la remise en route prend des heures. Les remèdes ne sont pas instantanés. Il faut :
- suspendre les déploiements pour ne rien ajouter à l’instabilité, ce que Microsoft a fait ;
- limiter le trafic et le réadmettre par paliers, pour éviter de resaturer ;
- ajouter de la capacité (machines virtuelles supplémentaires) ;
- changer la méthode de contrôle de santé, pour qu’un serveur lent ne soit pas retiré trop vite ;
- réparer ou reconstruire les machines bloquées « dans un mauvais état ».
5. Pourquoi on suspecte toujours un changement de configuration. C’est un schéma fréquent dans les post-mortems publiés par les grands fournisseurs : un changement de configuration jugé anodin, déployé largement, qui interagit mal avec le reste du système. Ici, le retour arrière d’un changement réseau récent est cohérent avec cette piste, mais Microsoft ne l’a pas confirmée.
Ce que les équipes d’ingénierie en retiennent, pour leurs propres systèmes :
- des health checks qui distinguent « lent » de « mort », pour ne pas amplifier une surcharge ;
- du délestage de charge (load shedding) et des disjoncteurs (circuit breakers) pour protéger les dépendances ;
- des reconnexions avec délai exponentiel et gigue (exponential backoff with jitter) côté clients, pour éviter l’effet de troupeau ;
- une remise en charge progressive (montée en trafic par paliers) après un incident ;
- des déploiements progressifs et un kill switch pour stopper un changement en quelques secondes ;
- un canal de communication de crise qui ne dépend pas de la plateforme en panne.
Nous détaillons des principes proches dans notre article DevOps expliqué simplement : pourquoi les entreprises accélèrent, et nous avons analysé un autre cas d’école de chaîne de confiance dans notre post-mortem technique du hack Binance.
Mes e-mails sont-ils perdus ? Vos données sont-elles en danger ?
À ce stade, non. Aucune source consultée ne fait état de données clients exposées ou perdues. Euronews note que rien de ce que Microsoft a dit ne suggère une exposition ou une perte de données.
- Les e-mails sont retardés, pas supprimés. Les serveurs expéditeurs réessaient d’envoyer les messages : Microsoft a étendu cette fenêtre de nouvelle tentative à 48 heures.
- Ne renvoyez pas tout. Renvoyer en masse crée des doublons quand la file se vide, et ajoute de la charge. Si un message est vraiment urgent, doublez-le par un autre canal (téléphone, messagerie instantanée), sans le renvoyer plusieurs fois.
- Attendez-vous à des arrivées en rafale et dans le désordre une fois le service stabilisé.
Que faire pendant la panne Microsoft 365 : checklist pour les entreprises
Pour tous les utilisateurs
- Vérifiez l’état officiel : page de statut
status.cloud.microsoftet compte @MSFT365Status sur X. - Utilisez Teams pour les appels, les réunions et le chat, qui fonctionnent en grande partie, mais évitez de modifier le calendrier ou les canaux.
- Basculez les échanges critiques sur un autre canal (téléphone, messagerie professionnelle alternative).
- Travaillez hors ligne : le mode Exchange mis en cache d’Outlook et les fichiers OneDrive synchronisés restent utilisables.
- Ne réinitialisez pas vos mots de passe et ne reconstruisez pas votre profil Outlook : le problème n’est pas chez vous, et ces gestes peuvent vous bloquer davantage.
Pour les administrateurs
- Suivez les incidents EX1550543 (Exchange Online) et MO1550821 (impact Microsoft 365) dans le centre d’administration, section Service health.
- Gelez les changements non essentiels (migrations, nouvelles règles de flux de messagerie, modifications d’identité).
- Préparez une communication à vos équipes et à vos clients, par un canal indépendant de Microsoft.
- Documentez l’impact (heures, utilisateurs, processus bloqués) : vous en aurez besoin pour une éventuelle demande de crédit.
SLA et crédits de service : comment réclamer
D’après LazyAdmin (à vérifier dans votre propre contrat), Microsoft s’engage sur 99,9 % de disponibilité mensuelle pour Microsoft 365. Les crédits de service sont de 25 % en dessous de 99,9 %, 50 % en dessous de 99 % et 100 % en dessous de 95 %. Ils ne sont pas automatiques : il faut ouvrir une demande dans le centre d’administration en citant les identifiants d’incident (si vous passez par un revendeur CSP, la demande se fait par son intermédiaire). LazyAdmin indique une échéance au 31 décembre 2026 : contrôlez la date applicable à votre contrat.
Que retenir pour la résilience de votre entreprise
Pour Rob Scott, d’UC Today, Microsoft 365 est devenu « un point de défaillance unique avec une interface familière ». La leçon n’est pas de quitter Microsoft : c’est de savoir comment vous fonctionnez le jour où il est indisponible. Voici le plan que nous recommandons aux PME :
- Cartographiez vos dépendances à la messagerie. Qui, quoi et quel processus s’arrêtent sans e-mail : facturation, signatures, support client, authentification par e-mail, alertes de supervision.
- Prévoyez un canal secondaire documenté et testé : annuaire téléphonique hors ligne, messagerie instantanée alternative, liste de diffusion de secours.
- N’envoyez jamais les alertes critiques uniquement par e-mail. Supervision, astreinte et alertes de sécurité doivent passer aussi par SMS ou une application d’astreinte.
- Gardez des comptes d’accès d’urgence (break-glass) hors de la chaîne d’authentification habituelle, stockés hors ligne et contrôlés.
- Sauvegardez vos données Microsoft 365 en dehors de Microsoft. Le modèle de responsabilité partagée laisse la sauvegarde au client : exportez contacts, calendriers, boîtes critiques.
- Envisagez un service de continuité de messagerie : une file d’attente indépendante qui reçoit vos e-mails entrants et offre un accès de secours pendant une panne.
- Visez la dégradation maîtrisée, pas le multi-cloud intégral. Dupliquer toute votre infrastructure est coûteux. Il est plus efficace de décider à l’avance quelles fonctions doivent continuer, avec quelles solutions de repli.
- Faites un exercice « journée sans Outlook » : deux heures, un scénario, et une liste de ce qui a coincé. C’est le meilleur retour sur investissement de la liste.
- Préparez un modèle de communication client : message prêt à envoyer, canal indépendant, responsable désigné.
Pour la partie infrastructure et cloud, notre article Cloud, DevOps et sécurité : faut-il migrer ses infrastructures en 2026 ? détaille les arbitrages pour le marché marocain.
Comparaison avec les pannes précédentes
- CrowdStrike (juillet 2024) : le ministre australien Tony Burke y a comparé cet incident. La comparaison est parlante par l’ampleur (compagnies aériennes, banques), mais les causes sont différentes : CrowdStrike était une mise à jour logicielle côté poste de travail, ici il s’agit d’une panne de service cloud.
- Panne réseau Azure de janvier 2023 : le 25 janvier 2023, un incident de réseau étendu avait perturbé Microsoft 365 et Teams pendant plusieurs heures (de 07:05 à 12:43 UTC selon TechRadar).
Chaque incident a sa cause propre. Ce qui se répète, c’est la concentration : quand un service que tout le monde utilise tombe, tout le monde tombe avec lui.
Questions fréquentes sur la panne Microsoft 365
Pourquoi Outlook ne fonctionne pas aujourd’hui ?
Parce que Microsoft subit une panne mondiale qui touche Exchange Online et Outlook depuis le 12 novembre 2026. Ce n’est pas un problème de votre ordinateur ni de votre connexion internet.
Comment savoir si Microsoft 365 est en panne ?
Consultez la page de statut officielle status.cloud.microsoft ou le compte @MSFT365Status sur X. Les administrateurs voient aussi l’état dans le centre d’administration Microsoft 365, section Service health. Le site Downdetector donne une vue en temps réel des signalements des utilisateurs.
Mes e-mails sont-ils perdus ?
Non, selon les informations disponibles : ils sont retardés. Les serveurs expéditeurs réessaient l’envoi et Microsoft a étendu la fenêtre de nouvelle tentative à 48 heures. Évitez de renvoyer les mêmes messages en masse.
Est-ce une cyberattaque ?
Microsoft indique n’avoir aucune indication d’activité malveillante ou de cyberattaque. La cause racine n’est pas encore confirmée : un post-incident report est promis.
Quand la panne sera-t-elle résolue ?
Microsoft n’a donné aucune estimation de fin au moment de la rédaction. La récupération se fait par phases et la capacité n’était pas encore revenue à son niveau normal. Suivez les incidents EX1550543 et MO1550821.
Cette panne touche-t-elle aussi AWS ou Google ?
Non. Amazon a indiqué qu’AWS fonctionnait normalement, et que des signalements d’utilisateurs venaient d’une perturbation sans rapport sur internet (CNBC). Les services qui ont eu des difficultés sont ceux qui dépendent de Microsoft 365, comme certains connecteurs d’outils tiers.
Faut-il quitter Microsoft 365 après cette panne ?
Pas nécessairement. Un autre fournisseur aura aussi ses pannes. Ce qui compte, c’est de préparer un fonctionnement dégradé : canal secondaire, sauvegarde indépendante, exercice de crise.
Conclusion
Cette panne n’est pas un événement exotique : elle rappelle qu’une infrastructure cloud, même immense, reste un système distribué qui peut s’effondrer en cascade. Ce qui fait la différence entre une journée perdue et un incident géré, c’est la préparation : savoir qui dépend de quoi, avoir un canal de secours, et s’être déjà entraîné.
Chez NeoLogix, nous concevons et exploitons des plateformes cloud et DevOps avec cette logique de dégradation maîtrisée. Si vous voulez faire le point sur vos dépendances et sur ce qui se passerait demain si un service critique tombait, écrivez-nous : contact@neologix.ma.
Sources (consultées le 13 novembre 2026)
- CNBC : Widespread Microsoft outage continues, taking down Outlook and other 365 services
- NBC News : Live updates, Microsoft scrambles to fix major outage
- ABC News : Microsoft Outlook outage updates
- Euronews : Microsoft outage explained, what went wrong and is your data at risk
- UC Today : Microsoft 365 outage, Outlook down and the fix won’t hold
- LazyAdmin : Microsoft 365 outage, current status and SLA credits
- KBY Technologies : Microsoft 365 outage November 2026, cause, impact and what to do
- Cybersecuritynews : Microsoft 365 massive outage, fixes fail as restored servers keep going unresponsive
- ITdaily : Microsoft 365 still offline, Outlook and Teams disrupted
- Presse-citron : Panne Outlook, Teams, Microsoft 365
- RTS : Microsoft 365, une panne mondiale touche Outlook et Teams
- Radio-Canada : Des milliers de Canadiens touchés par la panne mondiale de Microsoft
- TechRadar : Voici ce qui a causé l’énorme panne sur Microsoft 365 et Teams (janvier 2023)
Cet article est mis à jour au fil de l’incident. Dernière mise à jour : 13 novembre 2026.